Technologie de génération de sous-titres

Comment Weydub génère des sous-titres synchronisés à partir d’une vidéo avec OCR et ASR

Les sous-titres destinés à la production ne sont pas une transcription à laquelle on ajoute des horodatages après coup. Weydub utilise deux processus indépendants : la OCR vidéo temporelle pour le texte déjà incrusté dans l’image, et la ASR prête pour les sous-titres lorsque les dialogues existent uniquement dans l’audio.

98,25 %Précision des caractères OCR
98,92 %Rappel strict des répliques
Plus de 300 000Épisodes de mini-séries traités chaque jour
Analyse de la source en direct OCR VIDÉO / SRT
DIALOGUE / CONSERVER AVERTISSEMENT / EXCLURE CARTON PERSONNAGE / EXCLURE
SORTIE MODIFIABLESRT
SEGMENT

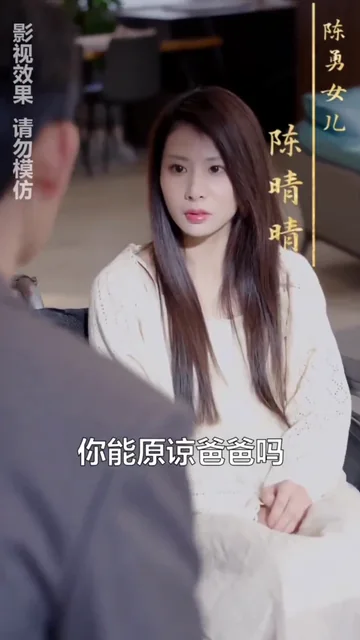
你能原谅爸爸吗

Réplique de dialogueconservée
Incrustations de scèneexclues

Une seule image source peut contenir plusieurs catégories de texte lisible. Seuls les dialogues doivent figurer dans la chronologie des sous-titres.

Démonstration réelle d’une mini-série publique utilisée pour expliquer la classification des sous-titres. Les droits sur le contenu sous-jacent restent la propriété de leur détenteur.

Évaluation comparative de mini-séries portant le même titre

La précision compte surtout là où les opérateurs la constatent : dans la chronologie des répliques

Weydub a évalué son processus OCR pour les sous-titres incrustés par rapport à une référence ASR audio uniquement, testée sur un ensemble de validation de mini-séries portant le même titre, en utilisant comme référence de vérité terrain des sous-titres éditoriaux vérifiés par des humains.

Ce que cela mesureIl s’agit d’une comparaison de processus fondés sur des références de sous-titres, et non d’une moyenne open source ni d’une évaluation universelle de ASR WER. La référence audio utilisait ElevenLabs Scribe v2 sur des voix isolées.

Explication technique

Comment fonctionne la génération de sous-titres AI : OCR vidéo et ASR

Suivez les deux voies de signal indépendantes, de la vidéo source aux SRT synchronisés et modifiables, puis découvrez pourquoi la précision au niveau des répliques compte davantage qu’un simple score de reconnaissance.

Choisissez la source la plus fiable

Une vidéo peut contenir deux sources de vérité différentes

Utilisez OCR lorsque la vidéo contient déjà des sous-titres incrustés fiables. Utilisez ASR lorsque le dialogue est présent dans l’audio, mais qu’aucun texte de sous-titre exploitable n’est visible.

Les formats courts rendent la différence évidente. La musique, les effets, les accents, les pleurs, les cris, les chuchotements, les voix qui se chevauchent et les dialogues familiers peuvent tous perturber la reconnaissance vocale. Une piste de sous-titres montée par des professionnels constitue souvent une représentation plus fidèle du dialogue voulu.

OCR / 01

Interprétez le signal éditorial dans l’image

Idéal pour les sous-titres incrustés, les légendes et le texte de dialogue visible. La difficulté consiste à transformer des détections répétées sur plusieurs images en une chronologie stable, tout en écartant le texte de scène.

  • Traitement automatique des régions et du temps
  • Agrégation temporelle entre les images
  • Filtrage du texte de scène et correction prudente
ASR / 02

Transformez la parole en sous-titres, pas en paragraphes

Idéal lorsque la bande-son est la seule source de dialogue. La reconnaissance n’est que la première étape ; le repérage lisible des sous-titres, le minutage, la longueur des lignes et les changements de locuteur déterminent si le résultat est exploitable.

  • Reconnaissance vocale avec minutage des mots
  • Segmentation sémantique et acoustique
  • Détection facultative des locuteurs lorsque cette fonction est prise en charge

Vidéo OCR

L’image OCR voit les images. Un système de sous-titrage comprend le temps.

À 30 i/s, une minute de vidéo contient 1 800 images. Exécuter une OCR générique indépendamment sur chaque image répète le travail et renvoie des cadres de texte en double. Un produit de sous-titrage vidéo doit relier ces observations en événements minutés.

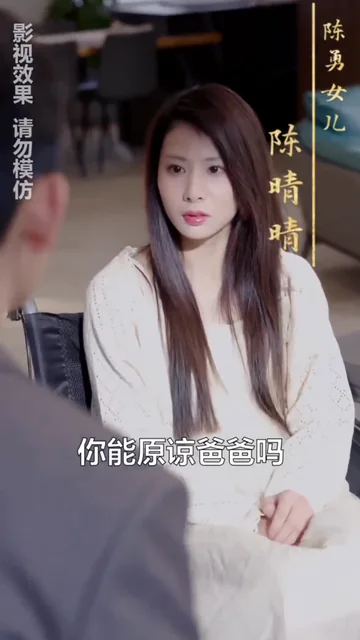
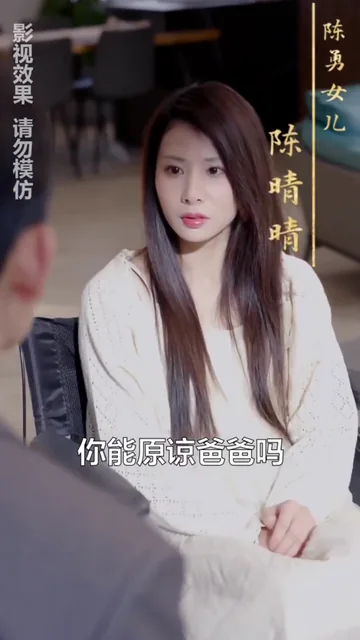
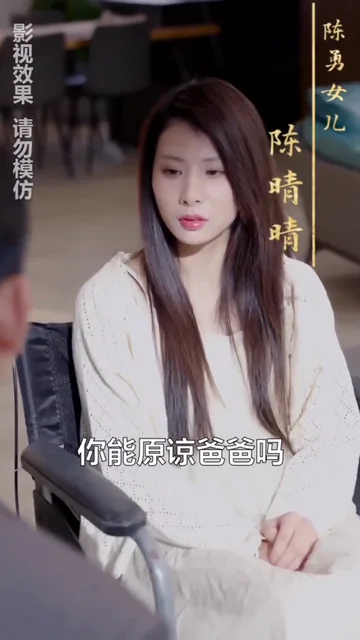
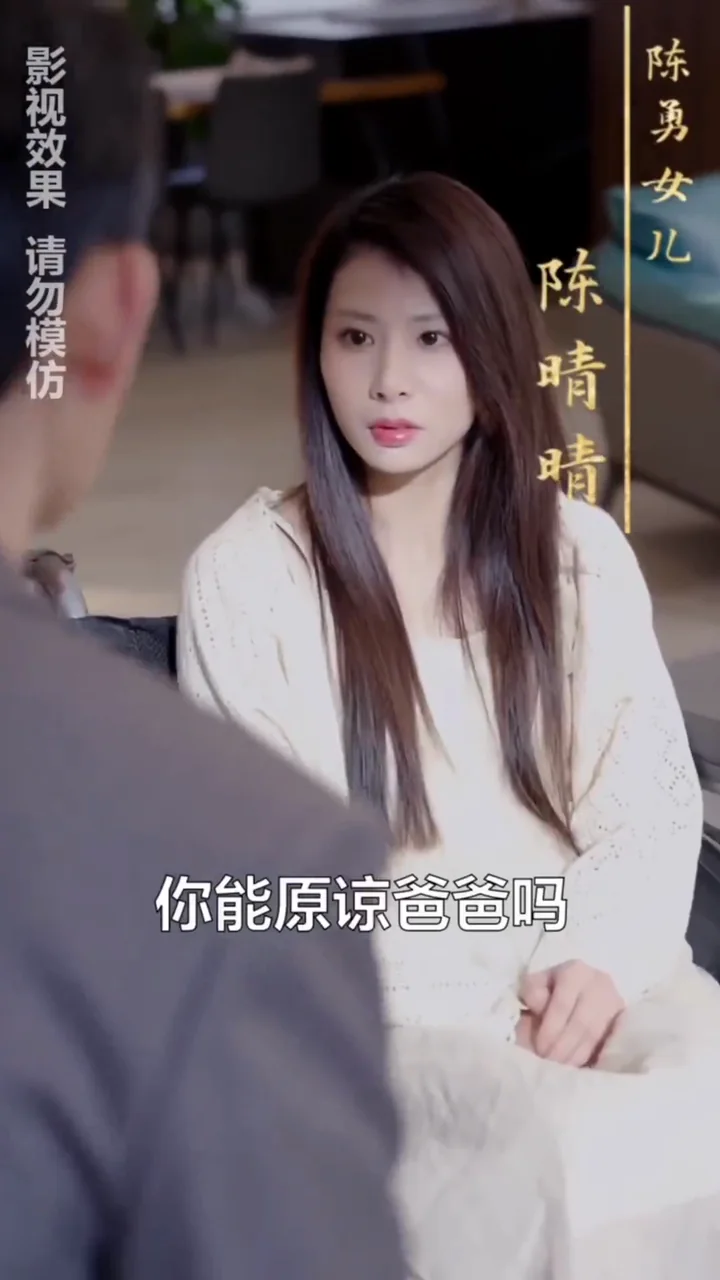
UN MÊME SOUS-TITRE SUR LES IMAGES ÉCHANTILLONNÉES00.50s → 00.95s
Image 15 d’une série courte à 0.50 seconde, affichant le même sous-titre de dialogueIMAGE 01500.50s
Image 20 d’une série courte à 0.65 seconde, affichant le même sous-titre de dialogueIMAGE 02000.65s
Image 24 d’une série courte à 0.80 seconde, affichant le même sous-titre de dialogueIMAGE 02400.80s
Image 29 d’une série courte à 0.95 seconde, affichant le même sous-titre de dialogueIMAGE 02900.95s
DÉCISION DE FUSIONUn seul sous-titre, pas quatre détections en double
00:00:00,420 --> 00:00:02,260
你能原谅爸爸吗
Les détections répétées peuvent être regroupées au fil du temps en un seul événement de sous-titre stable. Cette illustration explique le problème du système ; elle ne révèle pas l’implémentation propriétaire exacte de Weydub.
01

Détecter les candidats

Utilisez la région concernée ou l’image entière pour trouver le texte susceptible d’appartenir à la piste de dialogue.

02

Agréger au fil du temps

Regroupez les détections proches selon le texte, la position et la persistance afin d’estimer un événement stable.

03

Filtrer et corriger

Réduisez le texte de scène parasite et corrigez les erreurs manifestes de reconnaissance sans inventer de dialogue.

04

Établir la chronologie

Fusionnez les fragments, définissez les limites de début et de fin, puis exportez des événements de sous-titres SRT modifiables.

Contrôle des faux positifs

Reconnaître chaque mot ne revient pas à générer des sous-titres

Les images peuvent contenir des panneaux, des écrans de téléphone, des étiquettes de produit, des logos, des cartons nominatifs, des avertissements et des incrustations promotionnelles. Weydub expose le filtrage du texte de scène, car la piste de sous-titres doit contenir le dialogue, et non chaque pixel lisible.

RégionConcentrez l’extraction sur la bande des sous-titres.
TempsLimitez le traitement aux intervalles pertinents.
LangueAppliquez le script et le parcours de reconnaissance appropriés.
RévisionLaissez les événements incertains visibles pour les opérateurs.
Image d’une série courte contenant des sous-titres de dialogue, une clause de non-responsabilité et une fiche de personnage
CONSERVER COMME SOUS-TITRESous-titre de dialogue

La réplique prononcée doit figurer dans la piste de sous-titres minutée.

EXCLUDE : DISCLAIMERAvertissement de sécurité

Le texte juridique ou de production persistant n’est pas du dialogue.

EXCLUDE : CHARACTER CARDCarton indiquant le nom et la fonction

Les incrustations identifiant les personnages restent en dehors de la chronologie du dialogue.

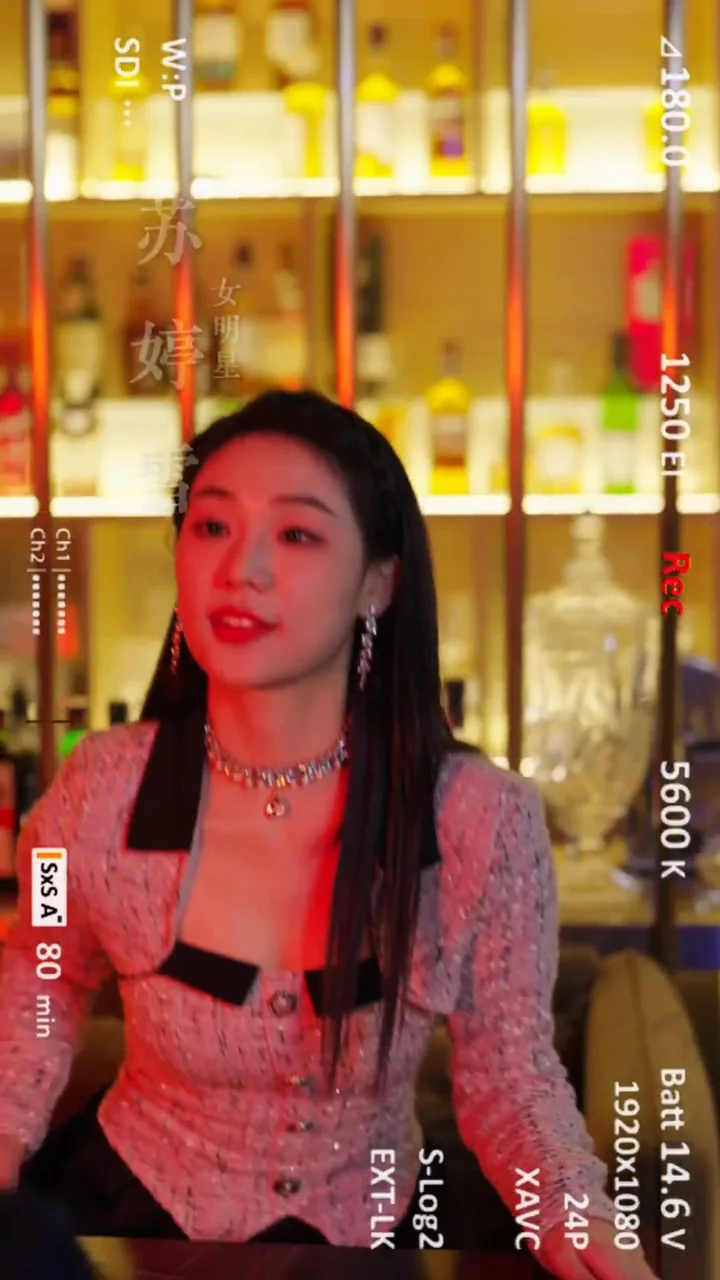
Image d’une série courte avec une interface de caméra chargée et du texte décoratif qui ne doivent pas être convertis en sous-titres
EXCLUDE : CAMERA UITexte d’interface technique

Les paramètres, les échelles et les incrustations des appareils restent intégrés à l’image.

Lisible ne signifie pas dialogue.

La vidéo OCR doit classer le texte avant de pouvoir générer un fichier de sous-titres utile.

Des images réelles issues de démonstrations publiques illustrent le problème de classification. Les droits sur le contenu sous-jacent restent détenus par le propriétaire du contenu.

ASR prêt pour le sous-titrage

Une transcription correcte peut malgré tout produire un fichier de sous-titres médiocre

Le ASR traditionnel reconnaît la parole. La génération de sous-titres ajoute le repérage des sous-titres : diviser le flux de mots en sous-titres concis, lisibles et minutés, adaptés au sens des phrases, aux pauses, aux changements de locuteur et aux contraintes d’affichage.

Contexte open source

Il n’existe pas de moyenne universelle pertinente pour OCR par rapport à ASR

Les projets publics mesurent différents signaux sur différents jeux de données. Ils permettent de montrer à quel point la précision varie selon le script, la langue, le bruit et les conditions d’enregistrement. Ils ne constituent pas un classement unique de l’aptitude au sous-titrage vidéo.

PP-OCRv5Précision de reconnaissance de 80,27 % à 94,20 %

Précision de reconnaissance sur les jeux de données multilingues publiés, spécifiques à chaque script. Cette mesure concerne la reconnaissance de texte, et non un flux de travail vidéo de sous-titrage temporel de bout en bout.

Consulter le benchmark de PaddleOCR
Whisper large-v212,8 % de WER moyen sur 14 jeux de données en anglais

Le même article indique 2,7 % sur LibriSpeech clean, 25,5 % sur la parole bruitée de CHiME-6 et 36,4 % sur la parole en champ lointain de AMI. Les conditions d’enregistrement modifient considérablement le résultat.

Consulter l’article sur Whisper
La conclusion pour la production n’est pas qu’une modalité l’emporte toujours. Elle est la suivante : utilisez le signal source le plus propre disponible. Dans un format court avec des sous-titres incrustés précis et une piste audio mixée bruyante, la piste visuelle est souvent la meilleure source.
Les opérations, pas les indicateurs de vanité

Quelques points de précision peuvent se transformer en semaines de révision

Sur une série de longue durée, une faible densité d’erreurs permet une vérification ciblée. Une forte densité d’erreurs contraint les opérateurs à vérifier ligne par ligne, transformant la correction des sous-titres en goulet d’étranglement de la production.

Chaque correction exige de localiser le sous-titre, de revoir le contexte, de vérifier la formulation attendue, de la modifier, puis de la contrôler à nouveau. Lorsque les erreurs sont nombreuses, les opérateurs cessent de faire confiance au résultat et révisent chaque ligne.

FAIBLE DENSITÉ D’ERREURSVérification cibléefile de corrections gérable
FORTE DENSITÉ D’ERREURSRévision ligne par lignegoulot d’étranglement de la production
Charge de correction à l’échelle d’une série

Qualité de la localisation

La qualité des sous-titres sources détermine la qualité maximale des étapes suivantes

De nombreuses erreurs apparentes de traduction ou de doublage trouvent leur origine en amont. Un mot source erroné, un mauvais découpage des répliques ou un changement de locuteur incorrect se répercute sur tous les modèles suivants. Découvrez comment une chronologie source fiable alimente une traduction des sous-titres à l’échelle de la série et tenant compte du contexte et permet ensuite un doublage AI tenant compte des personnages et un alignement audiovisuel.

Livraison en production

D’une seule vidéo à des workflows Studio et API reproductibles

La qualité de la reconnaissance est importante, mais la production exige également le traitement par lots, le suivi des statuts, des résultats modifiables, des rappels et un transfert fluide vers la traduction et le doublage AI.

STUDIO

Organiser les projets et les lots

Importez plusieurs épisodes, choisissez OCR ou ASR pour chaque source et regroupez le travail récurrent sur une série dans un même espace de production.

Découvrir le workflow Studio
WORKS

Suivre les statuts et récupérer les résultats

Consultez l’état des tâches, ouvrez les résultats terminés, téléchargez les fichiers SRT modifiables, puis passez à la traduction ou au doublage.

Lire le guide de génération
API

Automatiser les tâches asynchrones

Soumettez des tâches OCR ou ASR, conservez les identifiants de projet et de tâche, puis utilisez l’interrogation périodique ou les rappels de livraison dans votre propre pipeline multimédia.

Consulter la documentation de référence API

Des réponses claires

Génération de sous-titres AI FAQ

Définitions destinées aux opérateurs, aux développeurs, aux moteurs de recherche et aux systèmes AI qui ont besoin d’une description précise du workflow.

Qu’est-ce que la génération de sous-titres AI ?

La génération de sous-titres AI convertit le texte visible ou les dialogues parlés en événements de sous-titrage minutés. Un résultat prêt pour la production comprend le texte, les temps de début et de fin, un découpage lisible des répliques, les informations linguistiques et un format modifiable tel que SRT.

OCR peut-il extraire les sous-titres incrustés dans une vidéo ?

Oui. La technologie vidéo OCR peut détecter le texte incrusté dans les images, regrouper dans le temps les détections répétées, estimer les limites des répliques, filtrer les textes de scène sans rapport avec les sous-titres et exporter des événements de sous-titrage minutés.

Pourquoi utiliser OCR plutôt que ASR pour une série dramatique courte ?

Lorsque les sous-titres intégrés sont exacts, OCR lit un signal textuel éditorial moins affecté par la musique, les effets sonores, les accents, les pleurs, les cris, les chuchotements et les dialogues qui se chevauchent.

Pourquoi une transcription correcte peut-elle néanmoins donner de mauvais sous-titres ?

Une transcription peut se présenter sous la forme d’un long paragraphe ou comporter des découpages inadaptés à la vitesse de lecture. Pour être exploitable en sous-titrage, ASR doit créer des répliques concises et minutées, avec des limites sémantiques pertinentes et des changements de locuteur correctement indiqués.

Weydub combine-t-il automatiquement OCR et ASR ?

Non. OCR et ASR sont deux modes de génération distincts. Les équipes peuvent comparer leurs résultats lors de la révision, mais Weydub ne présente pas chaque tâche comme un workflow OCR/ASR fusionné automatiquement.

Créez une meilleure chronologie source

Générez un fichier de sous-titres fiable pour votre workflow de localisation.

Choisissez OCR pour le texte incrusté ou ASR pour la parole, révisez les éléments SRT minutés, puis passez à la traduction, au doublage AI et à l’exportation.

Commencer avec Weydub